Whisper 中文語音轉文字:用 Cloudflare 免費額度,每天 3.5 小時會議錄音轉逐字稿

開完一場 40 分鐘的會,要整理會議記錄,通常又要再花半小時😫
在 上一篇 我分享了自己做的 AI 助理,其中一個功能就是:手機錄完音上傳,幾分鐘後就有逐字稿、摘要和待辦。
語音轉文字這一步,我用的是 OpenAI 開源的 Whisper,跑在 Cloudflare Workers AI 上。選它的原因很簡單:Cloudflare 的免費方案,每天大約可以轉 214 分鐘(3.5 小時)的錄音,完全不用錢。
但 Whisper 拿來轉中文,也有不少坑:常常輸出簡體字、靜音的地方會自己編台詞、斷句很破碎。這篇就來分享我怎麼處理:
- Whisper 是什麼?中文可以用嗎?
- 各家語音轉文字 API 的價格比較
- Cloudflare 的免費額度怎麼算
- 怎麼呼叫 Cloudflare 的 Whisper API(附指令)
- 讓 Whisper 中文變好用的 5 個設定
- 最後讓 Claude 潤飾逐字稿,時間碼不能丟
- 實際跑一場 40 分鐘的會議,花多少錢、多久
Whisper 是什麼?中文可以用嗎?
Whisper 是 OpenAI 在 2022 年開源的語音辨識模型,支援中文在內的近百種語言,可以把錄音轉成有時間碼的文字。 因為是開源的,除了 OpenAI 自己,Cloudflare、Groq 這些平台也都有提供 Whisper 的 API。
中文可以用,而且一般的會議對話辨識得不錯。不過有三個地方要注意:
- 常常輸出簡體字。 就算你講的是台灣國語,它也常給你簡體。
- 不會分辨是誰在講話。 逐字稿不會標「A 說」「B 說」。
- 台語比較弱。 國台語夾雜的會議,辨識效果會打折扣。
第 1 點有解法,後面會講。第 2、3 點如果很重要,就要考慮其他方案。
延伸閱讀:OpenAI 的 Whisper 介紹
Whisper 要花多少錢?各家語音轉文字 API 比較
用 API 的話,Cloudflare 的 Whisper 最便宜:每分鐘 $0.0005,而且每天約 214 分鐘免費;OpenAI 自己的 Whisper API 是每分鐘 $0.006,貴了 12 倍。
我在做 AI 助理的時候,請 Claude Code 先上網比較了幾家,下面的價格我都再對過一次各家官方頁(2026 年 10 月):
| 方案 | 價格 | 換算每小時 | 特色 |
|---|---|---|---|
| Cloudflare Whisper(large-v3-turbo) | $0.0005/分鐘 | 約 $0.03 | 每天約 214 分鐘免費 |
| Groq Whisper(large-v3-turbo) | $0.04/小時 | $0.04 | 跟 Cloudflare 同一個模型,速度很快 |
| OpenAI gpt-4o-mini-transcribe | $0.003/分鐘 | $0.18 | |
| OpenAI gpt-transcribe | $0.0045/分鐘 | $0.27 | |
| OpenAI Whisper | $0.006/分鐘 | $0.36 | |
| OpenAI gpt-4o-transcribe-diarize | $0.006/分鐘 | $0.36 | 會分辨說話者 |
| Deepgram Nova-3(Cloudflare 上) | $0.0052/分鐘 | 約 $0.31 | |
| 雅婷 | 依方案 | — | 台灣團隊做的,國台語夾雜、分辨說話者比較強 |
(來源:Cloudflare Workers AI 價格、OpenAI API 價格、Groq 的 Whisper 公告)
如果你的會議主要是國語、不需要標出說話者,Cloudflare 的 Whisper 幾乎是免費的。 一個月開 20 小時的會,大部分天數都在免費額度裡。
Cloudflare 的免費額度怎麼算?
Cloudflare Workers AI 的免費方案,每天有 10,000 neurons 的免費額度;Whisper 轉 1 分鐘錄音大約用 46.63 neurons,所以每天大約可以轉 214 分鐘。
| 項目 | 數字 |
|---|---|
| 每天免費額度 | 10,000 neurons |
| whisper-large-v3-turbo 每分鐘用量 | 46.63 neurons |
| 每天免費可轉 | 約 214 分鐘(3.5 小時) |
| 額度重置時間 | 每天 00:00 UTC(台灣時間早上 8 點) |
| 超過免費額度 | 免費方案會直接報錯;付費方案每 1,000 neurons $0.011 |
neurons 是 Cloudflare 自己的計費單位,不同模型用量不一樣,你只要記得「1 分鐘錄音 ≈ 47 neurons」就好。
要注意的是,免費方案用超過不會扣錢,而是直接失敗。所以如果你一天的錄音會超過 3.5 小時,程式要能處理「今天額度用完,明天再轉」,或是升級到付費方案(Workers Paid 每月 5 美元起)。
怎麼呼叫 Cloudflare 的 Whisper API?
不用寫 Cloudflare Worker,直接打 REST API 就可以。 你需要兩個東西:
- Account ID:登入 Cloudflare 後台就看得到
- API Token:建立一個有 Workers AI Read 和 Workers AI Write 權限的 token
第一步:用 ffmpeg 把錄音轉檔、切段
手機錄音通常是 m4a,檔案也大。我會先轉成語音辨識最常用的格式:16kHz、單聲道、32kbps 的 mp3,再切成 10 分鐘一段:
ffmpeg -i meeting.m4a -vn -ac 1 -ar 16000 \
  -c:a libmp3lame -b:a 32k \
  -f segment -segment_time 600 -reset_timestamps 1 \
  chunk-%04d.mp3
10 分鐘的錄音轉完大約 2.4MB。切段是因為音檔要用 base64 塞進 JSON 送出去,一段太大容易出問題;切成小段也比較好重試。
第二步:送給 Whisper
# 音檔轉 base64,組成 request(不要直接塞在指令列,太長會出錯)
base64 < chunk-0000.mp3 | tr -d '\n' > audio.b64
jq -n --rawfile audio audio.b64 '{
  audio: $audio,
  language: "zh",
  vad_filter: true,
  condition_on_previous_text: false,
  initial_prompt: "以下是台灣的會議錄音逐字稿,使用繁體中文。"
}' > request.json

curl "https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/run/@cf/openai/whisper-large-v3-turbo" \
  -H "Authorization: Bearer $CLOUDFLARE_API_TOKEN" \
  -H "Content-Type: application/json" \
  -d @request.json
回傳的 result 裡有完整文字 text、每一句的時間 segments(含 start、end 秒數),還有字幕格式 vtt。
每一段的時間是從 0 開始算的,所以第 2 段(chunk-0001)的時間要加上 600 秒,接回整場會議的時間碼。
如果你不想自己寫程式,也可以把這篇丟給 Claude Code,跟它說「照這個做法幫我寫一個會議錄音轉逐字稿的工具」,它會幫你把上面這些串起來。
讓 Whisper 中文變好用的 5 個設定
這幾個設定是我實際跑過之後留下來的,每一個都對應一個坑:
1. 切成 10 分鐘一段 就是上面的 ffmpeg 指令。音檔小、好重試,某一段失敗也不用整場重來。
2. vad_filter: true:先切掉靜音
Whisper 有一個有名的毛病:遇到靜音或雜音,會自己編出不存在的句子。開啟 VAD(Voice Activity Detection,語音活動偵測),會先把沒人講話的部分濾掉再辨識。
3. condition_on_previous_text: false:避免重複句迴圈
預設 Whisper 會參考前面辨識出來的文字。好處是上下文比較連貫,壞處是前面錯了,後面可能一路錯下去,甚至卡在同一句話一直重複。Cloudflare 的文件也寫到,關掉它可以減少這種「幻覺迴圈」。
4. initial_prompt 用繁體中文寫,加上會議主題
提示詞本身用繁體中文,能引導 Whisper 輸出繁體。我還會把會議名稱放進去,例如「主題:AI 導入專案週會」,專有名詞會辨識得比較準。
5. 最後再用 OpenCC 轉成台灣繁體
就算有提示詞,Whisper 還是常常吐簡體。最後一道保險是用 OpenCC 轉成台灣繁體加台灣慣用詞(cn → twp),例如「软件」變「軟體」、「数据库」變「資料庫」。另外 Whisper 的中文常用半形標點,我會把中文字旁邊的 , ? 換成全形的「,」「?」。
最後一步:讓 Claude 潤飾逐字稿,時間碼不能丟
Whisper 轉出來的逐字稿是「一句一句」的,常常斷在奇怪的地方,也會有同音錯字,直接讀很累。
老實說,我自己很少直接看 Whisper 轉出來的原文,都是再過一次 Claude 潤飾之後才看,潤飾完基本上就 OK 了。所以這一步對我來說不是加分,是必要的。
給 Claude 的規則大概是這樣:
修正明顯的同音錯字,補上標點,把破碎的句子合併成段落 數字、金額、日期、人名、公司名、待辦事項都不可省略或改動意思 刪除無意義的口頭禪(嗯、那個、就是說),但不要摘要、不要改寫成書面報告 只有在內容能明確看出是誰在說話時才標說話者,不確定就不要猜 聽不清楚的地方保留原文並加上 [?]
這裡有一個小技巧:潤飾完的段落,要怎麼對回原本的時間碼?
我的做法是給每一行編號。Claude 回傳的每個段落,都要標出它涵蓋的是「第幾行到第幾行」,程式再用行號把時間碼接回去。如果 Claude 回傳的行號不合理(跳號、重疊),那一段就直接保留原文,不讓錯誤的對應污染時間碼。
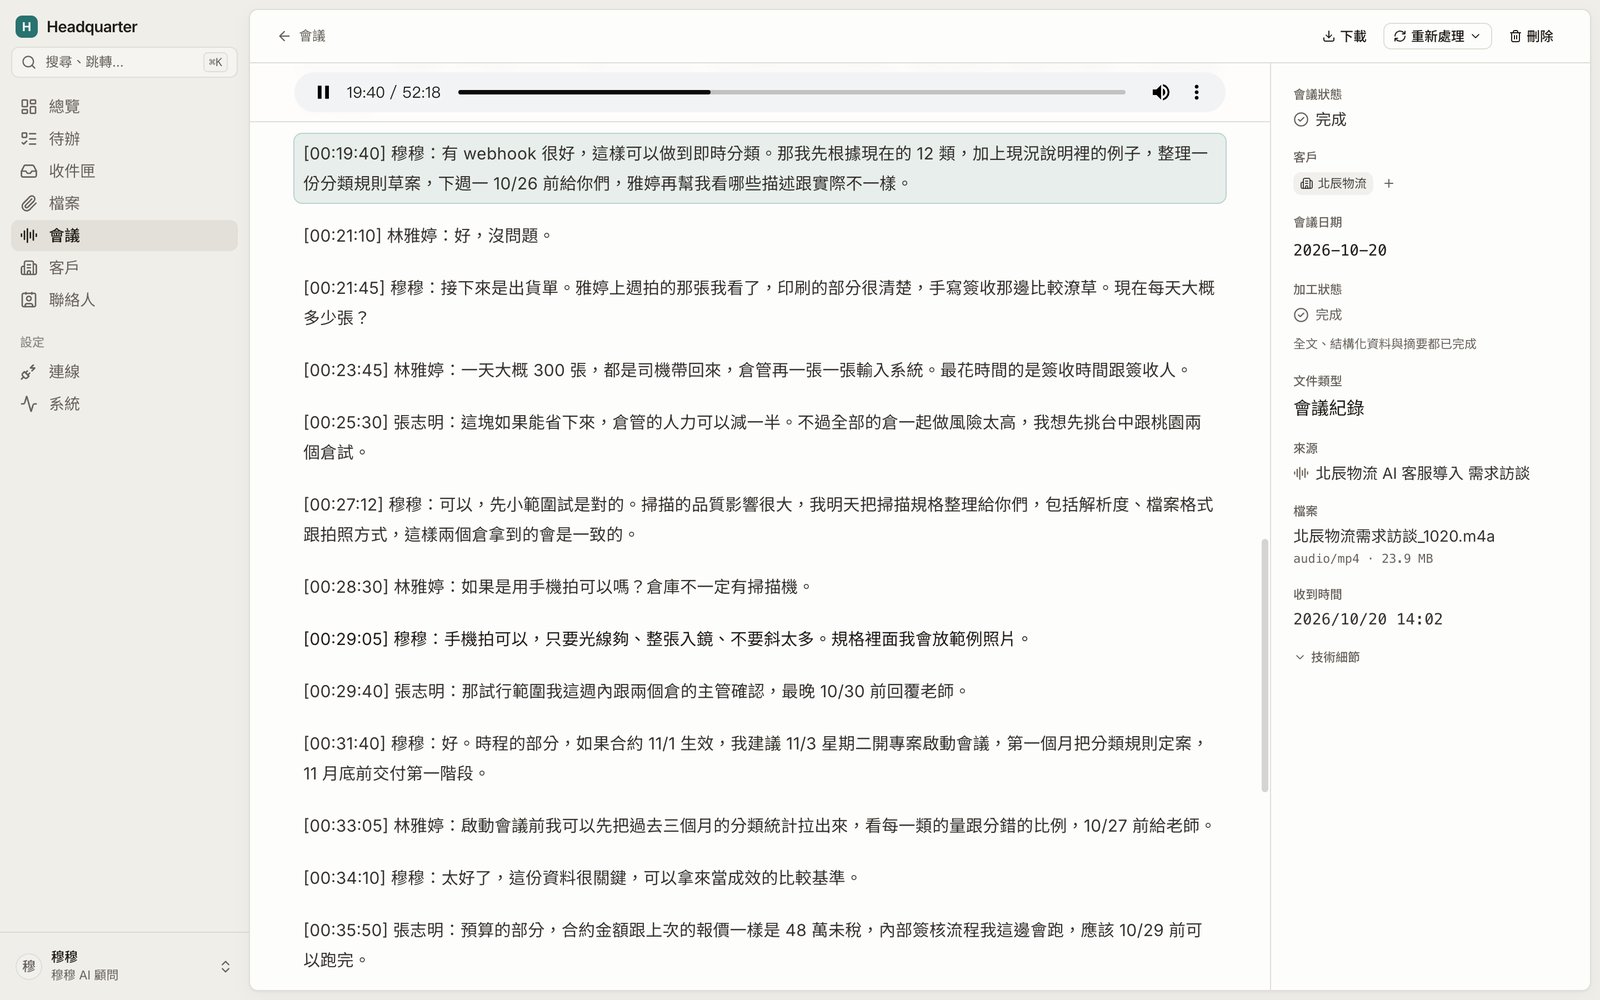
長的逐字稿會切成每 150 行一個窗口,分開潤飾。這樣不管潤飾得多徹底,每一段都還能點回錄音的第幾分幾秒,AI 寫的會議記錄才有辦法核對。
實際跑一場 40 分鐘的會議:花多少錢、多久?
一場 40.6 分鐘的會議,從上傳到摘要出來大約 5 分半,總共不到 0.3 美元,其中 Whisper 只佔 0.02 美元。 這是我正式環境跑過的實際紀錄:
| 步驟 | 做了什麼 | 花多久 | 花費 |
|---|---|---|---|
| 準備 | 上傳後排隊、ffmpeg 轉檔、切成 5 段 | 約 1 分鐘 | 免費 |
| Whisper | 5 段依序轉錄,每段 25~36 秒 | 約 2 分鐘 | 牌價 $0.02,在免費額度內實際 $0 |
| Claude 潤飾 | 分成 7 個窗口一起處理 | 約 20 秒 | $0.21 |
| Claude 分析 | 摘要、待辦、期限 | 約 20 秒 | $0.06 |
從上傳到摘要出來大約 5 分半(中間還有一些排隊等待),逐字稿 11,096 字,總共不到 0.3 美元。
最便宜的反而是 Whisper,真正花錢的是後面的 Claude 潤飾。 如果你只要粗略的逐字稿自己看,到第 5 個設定就夠了,幾乎零成本;如果要拿去給別人看、或讓 AI 再整理成會議記錄,潤飾這一步很值得。
什麼情況不適合用 Whisper?
- 很需要標出說話者:Whisper 做不到。可以考慮 OpenAI 的
gpt-4o-transcribe-diarize,或雅婷這類有說話者分辨的服務。 - 會議常常講台語:國際模型普遍比較弱,台灣團隊做的雅婷會比較好。
- 要即時字幕:這篇的做法是錄完再轉,即時的話要用串流型的模型。
常見問題
OpenAI Whisper 有中文版嗎?
Whisper 沒有分「中文版」,同一個模型就支援中文在內的近百種語言。只是它的中文輸出常常是簡體,台灣使用者通常要再轉成繁體。
Whisper 是免費的嗎?
模型本身是開源的,可以免費下載到自己電腦上跑,但需要不錯的顯卡才跑得快。不想自己架的話,用 API 最方便:Cloudflare 免費方案每天約 214 分鐘不用錢,超過再依用量計費。
Whisper 中文輸出是簡體怎麼辦?
兩招一起用:initial_prompt 用繁體中文寫,引導它輸出繁體;最後再用 OpenCC 的 cn → twp 轉成台灣繁體和台灣慣用詞,確保萬無一失。
Whisper 可以分辨說話者嗎?
不行。Whisper 只會把聲音轉成文字。我在潤飾時會請 Claude「能明確看出是誰說話才標」,例如有人自我介紹或被點名,但這不是真正的說話者辨識。真的需要的話,要換有 diarization 功能的服務。
錄音檔很長、很大,可以直接傳嗎?
建議先用 ffmpeg 轉成 16kHz 單聲道、切成 10 分鐘一段。一小時的錄音轉完大約 15MB 左右,切成 6 段,每段 2.4MB 上下,傳起來穩定很多。
結語
會議記錄這件事,以前要嘛自己邊開會邊打字,要嘛事後聽錄音整理。現在用 Whisper 加上 Claude,一場 40 分鐘的會,幾分鐘就有可以核對的逐字稿和摘要,而且語音轉文字這段幾乎不用錢。
如果你也常常開會、又懶得整理會議記錄,希望這篇對你有一丁點兒的幫助~
延伸閱讀:
喜歡這篇文章嗎?
📧 訂閱 Newsletter — 新文章直接寄到你信箱 🎬 追蹤我的 YouTube — 看 AI / 工具實作影片 💬 加我的 LINE — 有問題隨時問我 🧵 追蹤 Threads — 平常的工程隨筆
掰掰~👋